


Arquitecturas de datos masivos, lagos de datos (Data Lakes) y algoritmos prescriptivos para la confiabilidad.
Big Data en el Mantenimiento Industrial: Convirtiendo Terabytes en Confiabilidad
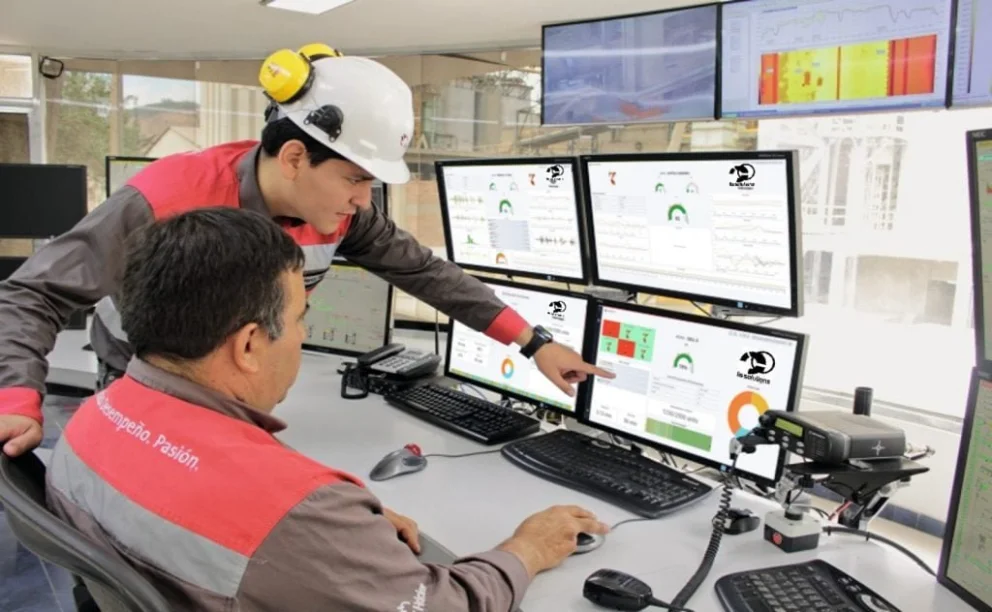
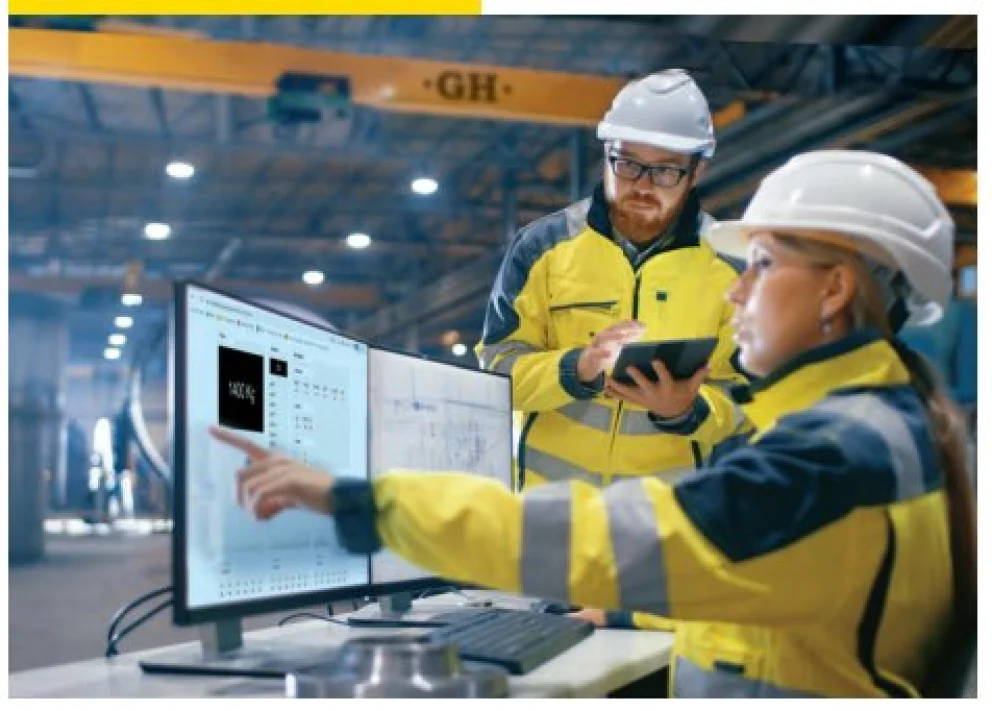
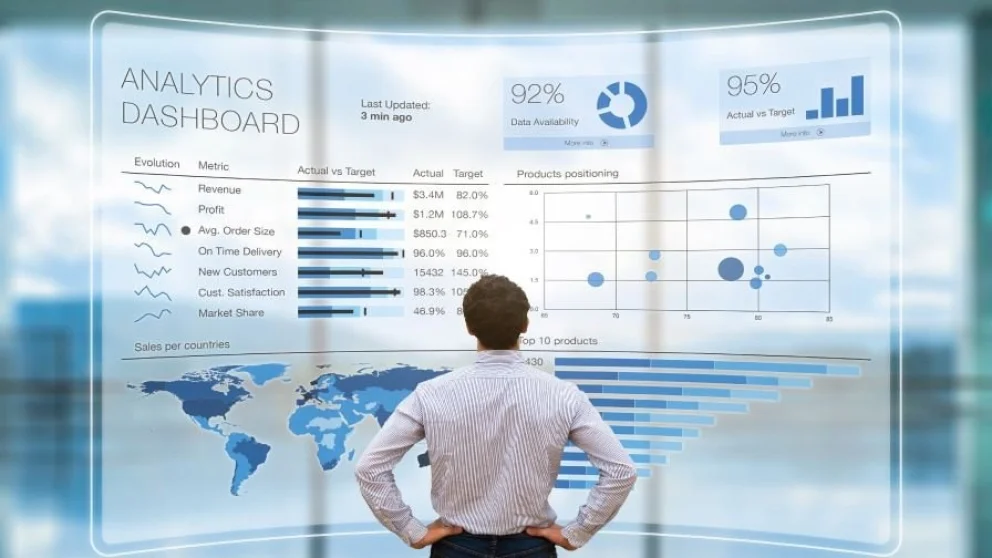
En el escenario fabril contemporáneo, una planta de producción mediana puede generar diariamente millones de puntos de datos provenientes de sus PLCs, sensores de vibración, registros de temperatura y consumos eléctricos. Durante años, esta información permaneció fragmentada en silos tecnológicos aislados: los datos de operaciones se quedaban en el SCADA, los mecánicos guardaban sus reportes en un CMMS/software de mantenimiento, y finanzas controlaba los repuestos desde el ERP. La convergencia de Big Data en el mantenimiento industrial rompe definitivamente estas barreras. Al unificar volúmenes masivos de datos heterogéneos en una infraestructura analítica centralizada, las compañías de alta competitividad migran del análisis predictivo básico hacia modelos prescriptivos avanzados capaces de predecir fallas sistémicas complejas y optimizar el costo de ciclo de vida de los activos de forma automatizada.
1. Las 4 "Vs" del Big Data Aplicadas a la Confiabilidad
Para entender cómo el Big Data transforma el piso de fábrica, la ingeniería de datos analiza el proceso a través de las cuatro dimensiones vectoriales clásicas de esta tecnología, adaptadas al entorno industrial:
Volumen: La cantidad masiva de datos generados. Un solo acelerómetro triaxial inalámbrico tomando datos de vibración a una tasa de muestreo de 25 kHz genera gigabytes de información cruda en pocas horas. Big Data aporta la infraestructura de almacenamiento elástica (como clústeres Hadoop o almacenamiento en la nube) para procesar estos datos sin saturar los servidores locales.
Velocidad: El flujo de datos en tiempo real. En procesos críticos (como el refino de petróleo o la generación de energía), los datos de presión y flujo deben analizarse en milisegundos para detectar transitorios hidráulicos (golpes de ariete) antes de que dañen las uniones estructurales.
Variedad: La heterogeneidad de las fuentes. Es el verdadero poder del Big Data. El sistema unifica datos estructurados (lecturas numéricas de sensores, órdenes de trabajo en SAP o IBM Maximo) con datos no estructurados (reportes en texto libre de los mecánicos, imágenes térmicas de drones, espectros de vibración acústica o análisis metalúrgicos).
Veracidad: La limpieza del dato. Los algoritmos filtran el "ruido" provocado por sensores descalibrados, pérdidas de conectividad Wi-Fi o datos erróneos de operación, asegurando que los modelos predictivos se entrenen con información físicamente válida.
2. Del Mantenimiento Predictivo al Prescriptivo
El procesamiento de Big Data mediante algoritmos de Inteligencia Artificial permite escalar en la pirámide de madurez de la gestión de activos, pasando de saber qué va a fallar a determinar qué acción comercial y técnica se debe tomar:
Fase Predictiva: Los sensores IIoT detectan que un rodamiento de un turbocompresor ha comenzado a desarrollar una frecuencia de falla BPFO y que la temperatura aumentó un 8%. El sistema emite una alerta indicando que el activo fallará en aproximadamente 14 días.
Fase Prescriptiva (El poder del Big Data): El motor analítico no se limita a dar la alerta. Cruza de inmediato el modelo de falla con el inventario de almacén del ERP para verificar si el repuesto exacto está disponible; revisa el plan de producción semanal para calcular el impacto económico de detener la máquina hoy versus detenerla el fin de semana; y analiza las hojas de ruta de los técnicos. Finalmente, el software emite una orden prescriptiva automática: "Para evitar el colapso, reduzca la velocidad de operación de la máquina un 15% (lo que estirará la vida útil del rodamiento a 22 días), genere automáticamente la orden de compra del repuesto ausente y programe la intervención del taller el próximo martes a las 06:00 AM durante la parada programada de limpieza".
3. Arquitectura Data Lake: El cerebro central de la Planta 4.0
Para lograr esta sinergia, las fábricas modernas implementan un Data Lake (Lago de Datos) Industrial. A diferencia de las bases de datos tradicionales que exigen estructurar la información antes de guardarla, el Data Lake recibe los flujos de datos en su formato nativo crudo.
Una vez depositados en el lago, los microservicios analíticos y las redes neuronales procesan la información de manera cruzada. Esto permite descubrir correlaciones invisibles para los analistas humanos, como por ejemplo, detectar que un lote específico de materia prima con mayor densidad está provocando micro-deformaciones estructurales en los ejes de los motores debido a sutiles incrementos de torque no registrados por las alarmas tradicionales del SCADA.
El Big Data es el cemento tecnológico que unifica la informática de gestión ($IT$) con la tecnología de operaciones de planta ($OT$). Gestionar el mantenimiento de una fábrica moderna analizando cada máquina de forma aislada a través de planillas de cálculo es limitar el potencial productivo y aceptar la ineficiencia de costos. La analítica de datos masivos transforma el mar de información del piso de fábrica en una ventaja competitiva medible, maximizando la disponibilidad de los activos y automatizando las decisiones de negocio más complejas. ¿Sigue tu planta operando con silos de información desconectados, o ya estás explotando el Big Data para prescribir el futuro de tu confiabilidad? El éxito industrial moderno ya no depende de acumular datos, sino de saber interpretarlos en conjunto.
","ad_server_empresa":"Troop","alto":"100","ancho":"377","alto_mobile":null,"ancho_mobile":null,"image":"https://cdn4.mantenimientoelectrico.com/s4/2026/02/12/mantenimientoelectrico/files/05/563/85eb8c849a33f3c85a7e8ed73e5d400dca87e9d08238e6d61791dc55931bb500.jpg","image_mobile":null,"url":"/paginas/p12-newsletter","url_mobile":"/paginas/p12-newsletter","target":"","target_mobile":""}])
","ad_server_empresa":"Troop","alto":"400","ancho":"377","alto_mobile":null,"ancho_mobile":null,"image":"https://cdn4.mantenimientoelectrico.com/s4/2026/02/12/mantenimientoelectrico/files/05/565/574968837e49cae6cba68222cfdfd1c90d04a410cb006735283e619ddc4e232c.jpg","image_mobile":null,"url":"/revista","url_mobile":"/revista","target":"","target_mobile":""}])
","ad_server_empresa":"Troop","alto":"100","ancho":"377","alto_mobile":null,"ancho_mobile":null,"image":"https://cdn4.mantenimientoelectrico.com/s4/2026/02/11/mantenimientoelectrico/files/05/560/976190fd342d06296c6714f4dd122fe26c250b592dc94d4de38a79db4d2b18f2.jpg","image_mobile":null,"url":"https://www.electroinstalador.com/","url_mobile":"https://www.electroinstalador.com/","target":"_blank","target_mobile":"_blank"}])
","ad_server_empresa":"Troop","alto":"100","ancho":"377","alto_mobile":null,"ancho_mobile":null,"image":"https://cdn4.mantenimientoelectrico.com/s4/2026/02/11/mantenimientoelectrico/files/05/561/71e816d95bb1f02574f6105b85f5f72c2c28f0f98e083eee1f018fc782292ffc.jpg","image_mobile":null,"url":"https://www.eficienciaconstructiva.com.ar/","url_mobile":"https://www.eficienciaconstructiva.com.ar/","target":"_blank","target_mobile":"_blank"}])
","ad_server_empresa":"Troop","alto":"100","ancho":"377","alto_mobile":null,"ancho_mobile":null,"image":"https://cdn4.mantenimientoelectrico.com/s4/2026/02/11/mantenimientoelectrico/files/05/562/752f11d61a6ff2822c56f21eba20d83bfbe9ec51f2a0539841646940865085c8.jpg","image_mobile":null,"url":"/mantenimiento-tv","url_mobile":"/mantenimiento-tv","target":"","target_mobile":""}])
","ad_server_empresa":"Troop","alto":"400","ancho":"377","alto_mobile":null,"ancho_mobile":null,"image":"https://cdn4.mantenimientoelectrico.com/s4/2026/02/13/mantenimientoelectrico/files/05/570/0ed6c3e311504c2fec5137b44af3f1dde94378d015c20a82b0585c1011f97d7e.jpg","image_mobile":null,"url":null,"url_mobile":null,"target":"_blank","target_mobile":"_blank"}])
