


Estrategias de procesamiento de datos en el borde para la optimización del mantenimiento predictivo.
Edge Computing: Inteligencia Industrial en tiempo real para el análisis de vibraciones
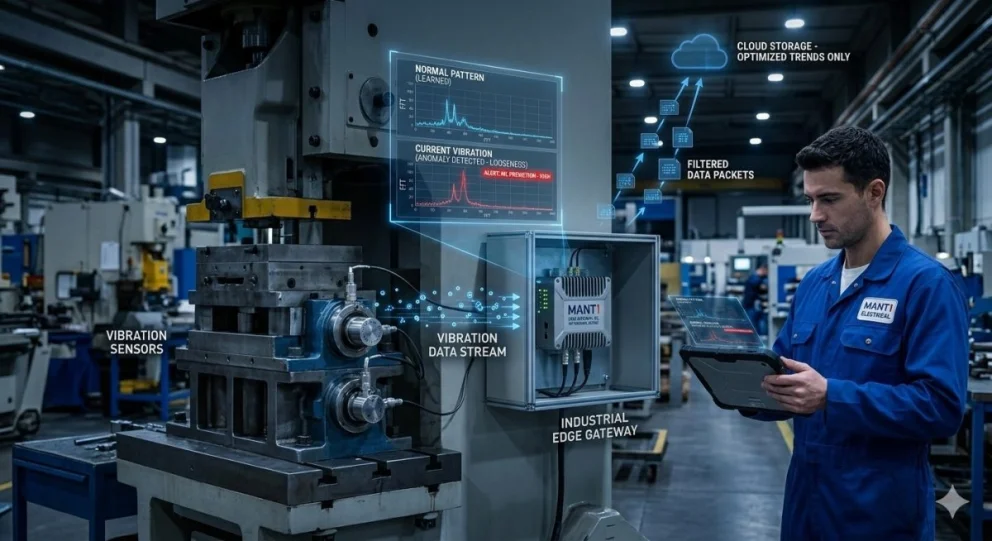
La evolución hacia la Industria 4.0 exige una capacidad de respuesta inmediata que la nube centralizada ya no puede garantizar por sí sola. La implementación de arquitecturas de Edge Computing permite ejecutar modelos de Machine Learning directamente en la planta, transformando datos brutos de vibración en Inteligencia Industrial procesable sin comprometer el ancho de banda ni la seguridad de la red corporativa.
El rol del Edge Computing en la pirámide de automatización de la Industria 4.0
En el modelo tradicional de automatización, los datos viajan desde los sensores hasta los controladores lógicos (PLC) y de ahí a sistemas SCADA o a la nube. Sin embargo, la Industria 4.0 ha introducido sensores de alta frecuencia que generan miles de muestras por segundo. Enviar esta cantidad de información a un servidor remoto genera cuellos de botella y costos de almacenamiento inasumibles. Aquí es donde el Edge Computing redefine la jerarquía: el procesamiento ocurre en el "borde" de la red, es decir, lo más cerca posible de la fuente del dato.
Al desplagar potencia de cálculo en el borde, la planta gana autonomía. Los dispositivos Edge no solo actúan como pasarelas de comunicación, sino que filtran, limpian y analizan los datos. Esto permite que solo la información relevante (como una alerta de falla o un resumen de tendencias) sea enviada a los niveles superiores, mientras que los datos de alta resolución se procesan localmente para una respuesta en milisegundos.
Arquitectura de hardware para el procesamiento de datos en el borde
Para sostener una estrategia de Inteligencia Industrial, es necesario contar con Gateways Industriales robustos. A diferencia de un router convencional, un dispositivo de Edge Computing industrial cuenta con procesadores multinúcleo capaces de ejecutar contenedores (como Docker) y sistemas operativos de tiempo real. Estos equipos están diseñados para soportar condiciones extremas de temperatura, interferencia electromagnética y vibración mecánica.
La arquitectura física suele incluir entradas de alta velocidad para sensores piezoeléctricos y protocolos de comunicación estándar como OPC UA o MQTT. La clave del hardware moderno es la inclusión de unidades de procesamiento tensorial (TPU) o aceleradores de IA, que están optimizados para realizar los cálculos matemáticos complejos que requieren los algoritmos de Machine Learning sin sobrecalentar el dispositivo ni consumir energía excesiva.
Despliegue de modelos de Machine Learning para la inferencia local
El flujo de trabajo en una arquitectura Edge comienza con el entrenamiento del modelo. Generalmente, el Machine Learning se entrena en la nube o en potentes servidores locales utilizando datos históricos de fallas. Una vez que el modelo ha aprendido a distinguir entre una vibración normal y una anomalía (como desalineación o soltura mecánica), el modelo "optimizado" se despliega en el dispositivo Edge. Este proceso se conoce como inferencia.
Realizar la inferencia en el borde significa que el dispositivo está constantemente comparando la vibración actual contra el patrón aprendido. Si el algoritmo detecta una desviación, puede activar una alarma local o incluso enviar una instrucción directa al PLC para reducir la velocidad de la máquina, todo esto antes de que un operario humano o un sistema en la nube siquiera haya recibido el paquete de datos. Esta capacidad de "decisión local" es lo que realmente define a una planta inteligente.
Ventajas de la Inteligencia Industrial distribuida frente a la nube
La transición hacia una Inteligencia Industrial distribuida mediante Edge Computing ofrece tres beneficios críticos que la computación centralizada no puede igualar:
Reducción de Latencia: En procesos críticos, esperar a que la nube procese una señal y devuelva una respuesta puede ser la diferencia entre una parada controlada y una rotura catastrófica. El Edge elimina el retardo de la red.
Seguridad y Privacidad: Al procesar los datos localmente, la información sensible de la producción no sale de la red interna de la planta, reduciendo la superficie de ataque para ciberamenazas externas.
Ahorro de Costos: Se reduce drásticamente el uso de ancho de banda y los costos de suscripción a servicios de almacenamiento en la nube, ya que solo se sube "el conocimiento", no el "dato bruto".
Conectividad y protocolos: El lenguaje del borde
Para que el Edge Computing sea efectivo, debe hablar el mismo lenguaje que los activos de planta. Protocolos como Modbus TCP, EtherNet/IP y, más recientemente, IO-Link, son esenciales para la extracción de datos. Sin embargo, para la comunicación hacia afuera del borde, el estándar de facto es MQTT por su ligereza y eficiencia en redes industriales. La capacidad de estos dispositivos para traducir protocolos antiguos a lenguajes modernos es lo que permite que máquinas con 20 años de antigüedad se integren en una estrategia de Industria 4.0 sin necesidad de reemplazarlas por completo.
El Edge Computing no ha llegado para reemplazar a la nube, sino para hacerla más inteligente. Al desplazar la capacidad de análisis y el Machine Learning al pie de la máquina, las empresas logran una verdadera Inteligencia Industrial capaz de predecir fallas con una velocidad y precisión sin precedentes. La descentralización del dato es, sin duda, el siguiente paso lógico en la madurez digital de la industria.
","ad_server_empresa":"Troop","alto":"100","ancho":"377","alto_mobile":null,"ancho_mobile":null,"image":"https://cdn4.mantenimientoelectrico.com/s4/2026/02/12/mantenimientoelectrico/files/05/563/85eb8c849a33f3c85a7e8ed73e5d400dca87e9d08238e6d61791dc55931bb500.jpg","image_mobile":null,"url":"/paginas/p12-newsletter","url_mobile":"/paginas/p12-newsletter","target":"","target_mobile":""}])
","ad_server_empresa":"Troop","alto":"400","ancho":"377","alto_mobile":null,"ancho_mobile":null,"image":"https://cdn4.mantenimientoelectrico.com/s4/2026/02/12/mantenimientoelectrico/files/05/565/574968837e49cae6cba68222cfdfd1c90d04a410cb006735283e619ddc4e232c.jpg","image_mobile":null,"url":"/revista","url_mobile":"/revista","target":"","target_mobile":""}])
","ad_server_empresa":"Troop","alto":"100","ancho":"377","alto_mobile":null,"ancho_mobile":null,"image":"https://cdn4.mantenimientoelectrico.com/s4/2026/02/11/mantenimientoelectrico/files/05/560/976190fd342d06296c6714f4dd122fe26c250b592dc94d4de38a79db4d2b18f2.jpg","image_mobile":null,"url":"https://www.electroinstalador.com/","url_mobile":"https://www.electroinstalador.com/","target":"_blank","target_mobile":"_blank"}])
","ad_server_empresa":"Troop","alto":"100","ancho":"377","alto_mobile":null,"ancho_mobile":null,"image":"https://cdn4.mantenimientoelectrico.com/s4/2026/02/11/mantenimientoelectrico/files/05/561/71e816d95bb1f02574f6105b85f5f72c2c28f0f98e083eee1f018fc782292ffc.jpg","image_mobile":null,"url":"https://www.eficienciaconstructiva.com.ar/","url_mobile":"https://www.eficienciaconstructiva.com.ar/","target":"_blank","target_mobile":"_blank"}])
","ad_server_empresa":"Troop","alto":"100","ancho":"377","alto_mobile":null,"ancho_mobile":null,"image":"https://cdn4.mantenimientoelectrico.com/s4/2026/02/11/mantenimientoelectrico/files/05/562/752f11d61a6ff2822c56f21eba20d83bfbe9ec51f2a0539841646940865085c8.jpg","image_mobile":null,"url":"/mantenimiento-tv","url_mobile":"/mantenimiento-tv","target":"","target_mobile":""}])
","ad_server_empresa":"Troop","alto":"400","ancho":"377","alto_mobile":null,"ancho_mobile":null,"image":"https://cdn4.mantenimientoelectrico.com/s4/2026/02/13/mantenimientoelectrico/files/05/570/0ed6c3e311504c2fec5137b44af3f1dde94378d015c20a82b0585c1011f97d7e.jpg","image_mobile":null,"url":null,"url_mobile":null,"target":"_blank","target_mobile":"_blank"}])
